
12 月 1 日之前需要改什么
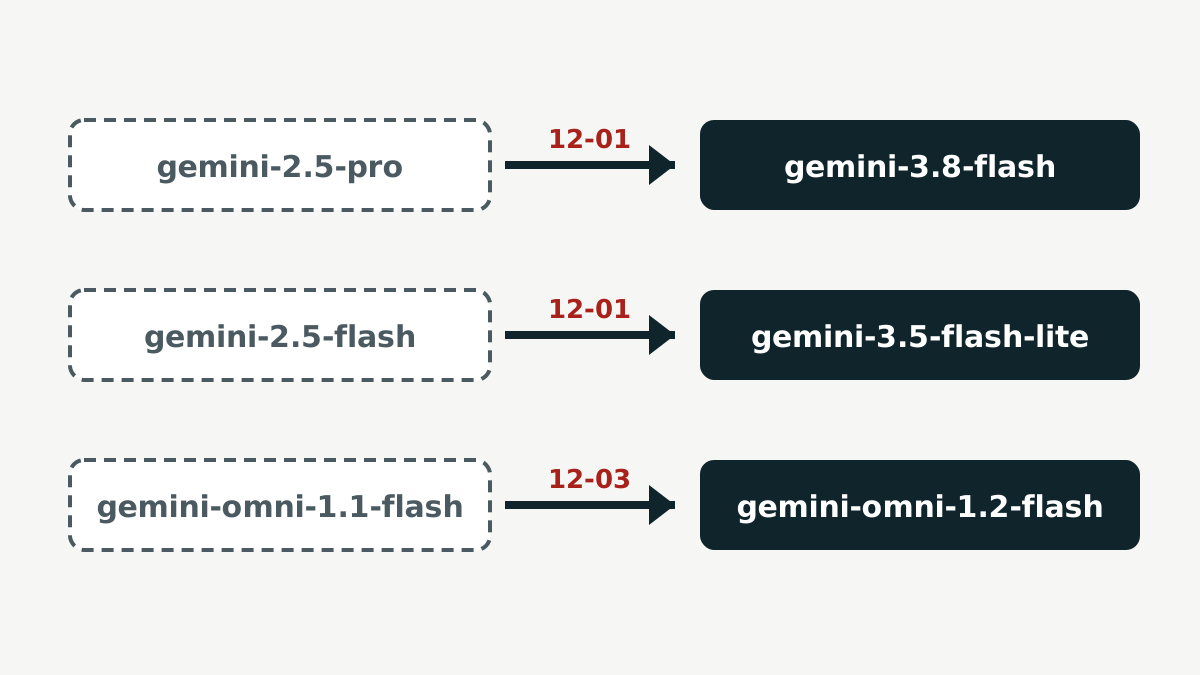
最紧急的是两个模型的停用。谷歌 11 月 2 日的版本说明称,Gemini 2.5 Pro 和 Gemini 2.5 Flash 已经无法在 Google AI Studio 中选择。从 2026 年 12 月 1 日起,API 会这样重定向把发往某个模型名的请求转给另一个模型,调用方不需要做任何改动请求:
gemini-2.5-pro转到gemini-3.8-flash,按 3.8 Flash 价格计费。gemini-2.5-flash转到gemini-3.5-flash-lite,按 3.5 Flash-Lite 价格计费。
你的应用仍会返回结果,但用的已经是另一个模型。谷歌列出了随之而来的不兼容变更:函数调用和 thought_signature 的校验更严格,thinking_level 取代 thinking_budget,部分采样参数以及预填的模型回合被移除。依赖这些功能的代码,在重定向开始后可能会出错或表现不同。谷歌建议在此之前更新模型名称,这样也能用你自己的提示词先测试新模型。
Gemini Omni 1.2 Flash 正式发布
正式发布稳定版本,支持在生产环境中使用;与之相对,预览版可能随时变化意味着 gemini-omni-1.2-flash 现在可以用于生产。根据版本说明,它可以生成最长 15 秒的视频,并支持对话式编辑,也就是通过描述修改内容来调整片段。视频输出价格为每百万 token 12.00 美元,比之前低 30%,付费层级的速率限制也翻了一倍。
上一版本 gemini-omni-1.1-flash 将从 2026 年 12 月 3 日起重定向到 1.2 Flash,按 1.2 Flash 的价格计费。
这两周的其他变化
- 10 月 26 日:使用
generateContent、streamGenerateContent和batchGenerateContent的新付费项目默认保存请求(store=true),现有项目保持原设置。可以在每个请求中用store=false关闭,或在 Logs and Datasets 设置中关闭。如果你的应用会发送个人或机密数据,请检查这项设置。 - 10 月 27 日:命令行客户端
gemini-api进入测试阶段,面向编程智能体、脚本和 CI 流水线。 - 10 月 30 日:Computer Use让模型操作电脑界面、在屏幕上点击和输入以完成任务的工具工具正式发布。
- 11 月 4 日:Gemini 3.8 Flash TTS 可以根据自然语言指令创建并保存自定义声音。
- 11 月 5 日:API 支持 PPT、ODP 和 ODS 文件作为输入,工具也可以把音频、视频和 Office 文件返回给模型。
版本说明只讲了改了什么,没有讲模型表现如何。如果想要可以在自己硬件上运行的模型,请看我们关于 Mistral Large 4 开放权重的文章;关于 AI 在安全研究中的作用,Chrome 157 更新把 21 个修复归功于 AI 辅助的工作。
信息来源
本文核对过的一手来源: